OpenAI afirma que sua IA resolveu 372 problemas matemáticos abertos. Os matemáticos estão céticos
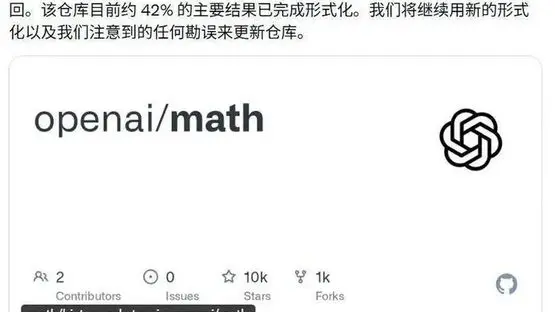
No início de outubro, a OpenAI publicou 722 manuscritos matemáticos no GitHub, todos gerados por um único modelo interno que a empresa nunca tornou público. Segundo a OpenAI, o sistema abordou cerca de 4.000 problemas abertos em 17 ramos da matemática — teoria dos números, geometria, probabilidade e ciência da computação teórica, entre eles — e produziu resultados em 372 deles. O anúncio ocorreu menos de três meses depois de a matemática chinesa Wang Hong ganhar uma Medalha Fields, a mais alta honraria da disciplina, por seu trabalho na versão tridimensional da conjectura de Kakegawa. O modelo da OpenAI, sugeriu a empresa, havia ido uma dimensão além.
Foi esse enquadramento que fez a publicação se espalhar. A matemática tornou-se um campo de provas improvável para a inteligência artificial, porque, ao contrário da escrita de ensaios ou da geração de imagens, uma prova pode ser verificada. Uma prova correta é correta para sempre; uma errada pode ser demolida por qualquer estudante de pós-graduação competente. Vencedores da Medalha Fields, e não departamentos de marketing, são os árbitros naturais.
O problema é o volume. Setecentos e vinte e dois manuscritos não são um artigo. É uma pequena biblioteca, e lê-la exige o tipo de atenção lenta e adversarial que não pode ser terceirizada para a mesma classe de modelo que a escreveu. Os matemáticos que começaram a examinar os arquivos descrevem um cenário misto: argumentos que parecem plausíveis até um passo específico, definições que mudam silenciosamente de significado no meio do caminho e resultados ocasionais que parecem genuinamente novos.
Divulgadores científicos chineses foram mais diretos. Um ensaio amplamente compartilhado comparou a publicação à descoberta de uma montanha de lixo, com pesquisadores tapando o nariz e garimpando em busca de ouro. A imagem é pouco gentil, mas captura o trabalho real envolvido. Alguém precisa decidir, linha por linha, quais daqueles 372 resultados alegados sobrevivem ao contato com um especialista humano.
Esse é um padrão familiar no aprendizado de máquina. Sistemas que geram soluções candidatas superam em muito os humanos disponíveis para verificá-las, seja em matemática, descoberta de fármacos ou ciência dos materiais. A verificação torna-se o gargalo, e o gargalo determina o valor real da ferramenta. Um modelo que propõe dez mil hipóteses é tão útil quanto o laboratório capaz de testá-las.
Há também uma questão mais profunda sobre o que o modelo está fazendo. Os matemáticos distinguem entre encontrar uma prova e entender por que um teorema é verdadeiro. Uma máquina pode buscar uma cadeia de passos válidos sem compreender a estrutura que torna o resultado inevitável, e é essa estrutura que permite aos humanos estender um resultado a novos casos. Se os manuscritos da OpenAI contêm provas válidas, mas nenhuma intuição, eles ainda podem ser úteis — mas não mudarão, por si sós, a forma como o campo pensa.
Por ora, a resposta honesta é que ninguém sabe. Os manuscritos são públicos, as alegações são específicas o suficiente para serem verificadas, e a verificação começou. É assim que a matemática sempre resolveu disputas, e é um processo mais lento do que um anúncio de produto.
O que o episódio mostra, porém, é que as empresas de IA decidiram que a matemática é a arena onde podem fazer suas alegações mais críveis. O campo oferece algo raro no debate sobre IA: um veredito que não depende da opinião de ninguém. Se mesmo uma fração desses 372 resultados se sustentar, a publicação será lembrada como um marco. Se a maioria desmoronar sob escrutínio, será lembrada como uma lição sobre a lacuna entre gerar texto e produzir conhecimento.