OpenAI afirma que su IA resolvió 372 problemas matemáticos abiertos. Los matemáticos son escépticos
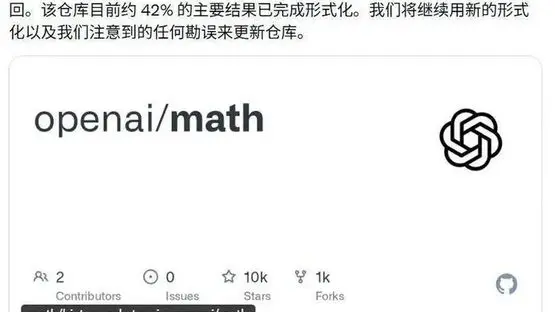
A principios de octubre, OpenAI publicó 722 manuscritos matemáticos en GitHub, todos generados por un único modelo interno que la empresa nunca ha hecho público. Según OpenAI, el sistema abordó aproximadamente 4.000 problemas abiertos en 17 ramas de las matemáticas —teoría de números, geometría, probabilidad e informática teórica, entre ellas— y produjo resultados en 372 de ellos. El anuncio se produjo menos de tres meses después de que la matemática china Wang Hong ganara una Medalla Fields, el máximo honor de la disciplina, por su trabajo sobre la versión tridimensional de la conjetura de Kakegawa. El modelo de OpenAI, sugirió la empresa, había ido una dimensión más allá.
Ese encuadre es lo que hizo que la publicación se difundiera. Las matemáticas se han convertido en un terreno de prueba improbable para la inteligencia artificial, porque, a diferencia de la escritura de ensayos o la generación de imágenes, una demostración puede verificarse. Una demostración correcta es correcta para siempre; una incorrecta puede ser demolida por cualquier estudiante de posgrado competente. Los ganadores de la Medalla Fields, no los departamentos de marketing, son los árbitros naturales.
El problema es el volumen. Setecientos veintidós manuscritos no son un artículo. Es una pequeña biblioteca, y leerla requiere ese tipo de atención lenta y adversarial que no puede delegarse a la misma clase de modelo que la escribió. Los matemáticos que han comenzado a revisar los archivos describen un panorama mixto: argumentos que parecen plausibles hasta un paso específico, definiciones que cambian silenciosamente de significado a mitad de camino y resultados ocasionales que parecen genuinamente nuevos.
Los divulgadores científicos chinos han sido más directos. Un ensayo ampliamente compartido comparó la publicación con el descubrimiento de una montaña de basura, con investigadores tapándose la nariz y rebuscando en ella en busca de oro. La imagen es poco amable, pero captura el trabajo real que implica. Alguien tiene que decidir, línea por línea, cuáles de esos 372 resultados declarados sobreviven al contacto con un experto humano.
Este es un patrón familiar en el aprendizaje automático. Los sistemas que generan soluciones candidatas superan con creces a los humanos disponibles para verificarlas, ya sea en matemáticas, descubrimiento de fármacos o ciencia de materiales. La verificación se convierte en el cuello de botella, y el cuello de botella determina el valor real de la herramienta. Un modelo que propone diez mil hipótesis es tan útil como el laboratorio que puede probarlas.
También hay una pregunta más profunda sobre lo que hace el modelo. Los matemáticos distinguen entre encontrar una demostración y comprender por qué un teorema es verdadero. Una máquina puede buscar una cadena de pasos válidos sin captar la estructura que hace inevitable el resultado, y es esa estructura la que permite a los humanos extender un resultado a nuevos casos. Si los manuscritos de OpenAI contienen demostraciones válidas pero ninguna idea, pueden seguir siendo útiles, pero no cambiarán por sí solos la forma en que piensa el campo.
Por ahora, la respuesta honesta es que nadie lo sabe. Los manuscritos son públicos, las afirmaciones son lo suficientemente específicas como para ser verificadas, y la verificación ha comenzado. Así es como las matemáticas siempre han resuelto las disputas, y es un proceso más lento que un anuncio de producto.
Lo que sí muestra el episodio es que las empresas de IA han decidido que las matemáticas son el terreno donde pueden hacer sus afirmaciones más creíbles. El campo ofrece algo raro en el debate sobre la IA: un veredicto que no depende de la opinión de nadie. Si aunque sea una fracción de esos 372 resultados se sostiene, la publicación será recordada como un hito. Si la mayoría se derrumba bajo escrutinio, será recordada como una lección sobre la brecha entre generar texto y producir conocimiento.