ハーバード大学とGoogleの研究:GPT-6 Astraが物理問題の98%を解決
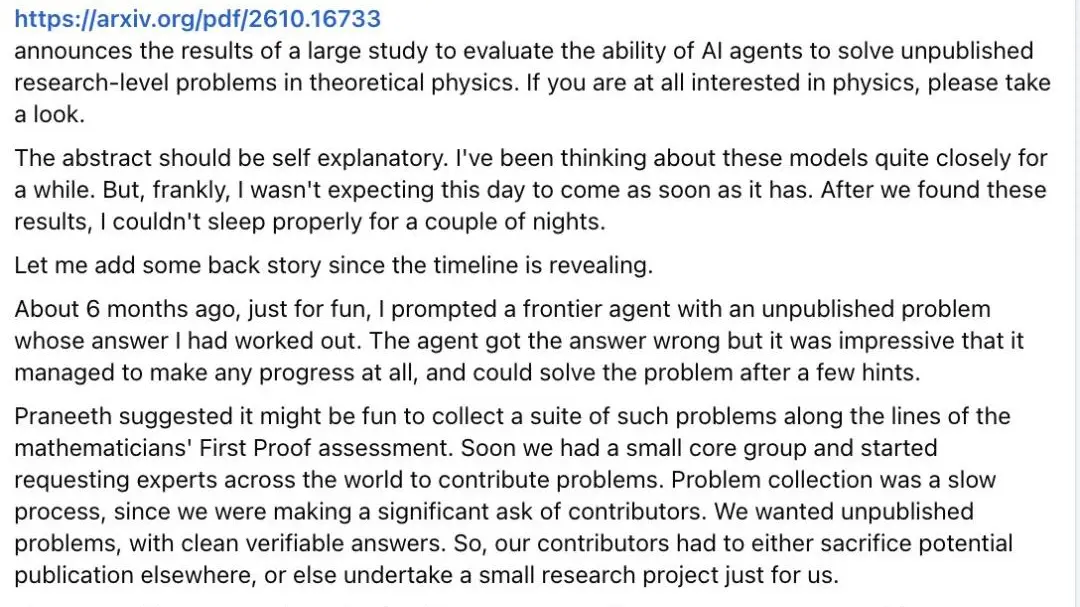
ハーバード大学とGoogleの共同研究が、未発表の理論物理学の問題でフロンティアAIをテストするベンチマークで学界に波紋を広げている。中国のテックメディアで流れている報道によると、TheoPhysEvalと呼ばれる評価は、一流の人間専門家が解決するのに丸一日かかるとされる新鮮な問題に先進モデルを挑ませた。際立ったパフォーマンスを見せたのはGPT-6 Astraと呼ばれるモデルで、問題の98%を解決したと報じられている。
最も印象的な詳細は、ほぼ完璧なスコアではなく、モデルがそこに至った方法である。報道によれば、GPT-6 Astraは当初88%を獲得し、その後、テストを設計した人間の専門家が設定した問題の一つに計算ミスがあると指摘した。専門家がレビューして誤りを認めた後、モデルのスコアは98%に上昇した。この逸話が正確であれば、象徴的な瞬間を示す:AIシステムがフロンティアの問いに答えるだけでなく、それを作成した人々を訂正するのである。
TheoPhysEvalは、多くのAIベンチマークを悩ませる汚染問題を避けるように設計されている。モデルがトレーニング中に見た可能性のある公開論文を利用する代わりに、未発表の新しく書かれた問題を使用する。狙いは、想起ではなく真の推論をテストすることだ。モデルが正確な問題に以前遭遇することなく新しい理論物理学を解き進めることができれば、それはより一般的な能力を示唆する。
この結果は、AIの数学的・科学的能力の広範な加速の中で出てきた。10月初旬、OpenAIはそのシステムが準リーマン予想を証明したと主張し、数学者たちは人間が生み出したならフィールズ賞に値すると述べた。数日以内に、研究者たちはAIの支援を受けて数学者が一般化リーマン予想の一形態を証明したと報告した。このペースは一部の学者を興奮させ、他の者を不安にさせている。
MITの研究者たちも意見を述べており、報道は過去2年間でフロンティアAIが理論科学の問題解決において急速な進歩を遂げたことを示す独自のテストを引用している。トレンドラインは、AIが科学者を支援するツールから、結果を提案し検証できる参加者へと移行していることを示唆している。この移行は、機械がループに入っているときに、功績、検証、査読がどのように機能すべきかという疑問を提起する。
懐疑論者は、特に詳細が査読論文ではなく報道を通じてフィルタリングされる場合、ベンチマークの結果は誇張される可能性があると警告している。TheoPhysEvalの正確な構成、テストされた問題の数、評価の独立性は公に完全に詳述されていない。方法論が公開され再現されるまで、98%という数字は確定した事実ではなく、注視すべき主張として扱うべきである。
それでも、この話はある雰囲気を捉えている。何十年もの間、理論物理学は最も人間的な営みの一つであり、直感、数学的流暢さ、そして長年の訓練を必要とした。専門家の算術ミスを指摘できると報じられるモデルは、それらの壁が多くの人が想定していたより低いことを示唆している。これが突破口なのか、タイミングの良い見出しなのか、科学におけるAIについての会話は、支援できるかどうかから、最終的にどれだけの仕事をするのかへと移っている。