Harvard en Google-studie: GPT-6 Astra lost 98% van de natuurkundeproblemen op
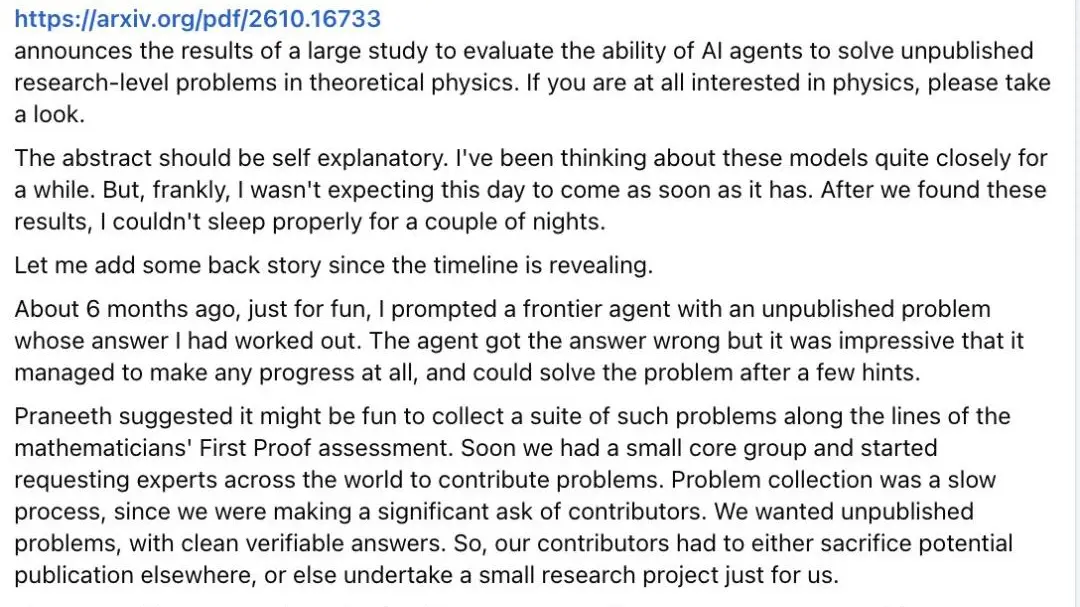
Een onderzoekssamenwerking tussen Harvard en Google heeft opschudding veroorzaakt in academische kringen met een benchmark die geavanceerde AI test op ongepubliceerde theoretische natuurkundeproblemen. Volgens berichten die circuleren in Chinese technologiemedia, vroeg de evaluatie, genaamd TheoPhysEval, geavanceerde modellen om nieuwe problemen aan te pakken waarvan naar verluidt topmenselijke experts een volledige dag nodig hebben om ze op te lossen. De uitblinker was een model dat wordt aangeduid als GPT-6 Astra, dat naar verluidt 98% van de problemen oploste.
Het meest opvallende detail is niet de bijna perfecte score, maar hoe het model daar kwam. Berichten zeggen dat GPT-6 Astra aanvankelijk 88% scoorde en vervolgens een rekenfout markeerde in een van de problemen die door de menselijke experts die de test ontwierpen waren opgesteld. Nadat de experts de fout hadden herzien en erkend, steeg de score van het model naar 98%. Dat anekdotische verhaal, als het klopt, markeert een symbolisch moment: een AI-systeem dat niet alleen een grensverleggende vraag beantwoordt, maar de mensen die hem schreven corrigeert.
TheoPhysEval is ontworpen om het contaminatieprobleem te vermijden dat veel AI-benchmarks teistert. In plaats van gebruik te maken van gepubliceerde artikelen die modellen tijdens training hebben gezien, gebruikt het ongepubliceerde, vers geschreven problemen. Het idee is om echt redeneren te testen in plaats van herinnering. Als een model nieuwe theoretische natuurkunde kan doorwerken zonder het exacte probleem eerder te zijn tegengekomen, suggereert dat een meer algemene capaciteit.
Het resultaat komt te midden van een bredere versnelling van de wiskundige en wetenschappelijke vaardigheden van AI. Begin oktober beweerde OpenAI dat zijn systemen een quasi-Riemannhypothese hadden bewezen, een resultaat dat wiskundigen als Fields Medal-waardig beschreven als het door een mens was geproduceerd. Binnen enkele dagen meldden onderzoekers dat wiskundigen met AI-hulp een vorm van de gegeneraliseerde Riemannhypothese hadden bewezen. Het tempo heeft sommige academici opgetogen gemaakt en anderen ongemakkelijk.
Ook onderzoekers van MIT hebben zich uitgelaten, met berichten die verwijzen naar hun eigen tests waaruit blijkt dat geavanceerde AI de afgelopen twee jaar snelle vooruitgang heeft geboekt bij het oplossen van theoretische wetenschapsproblemen. De trendlijnen suggereren dat AI verschuift van een hulpmiddel dat wetenschappers bijstaat naar een deelnemer die resultaten kan voorstellen en controleren. Die verschuiving roept vragen op over hoe erkenning, verificatie en peer review zouden moeten werken wanneer een machine in het proces betrokken is.
Sceptici waarschuwen dat benchmarkresultaten overdreven kunnen worden, vooral wanneer details via persberichten worden gefilterd in plaats van via peer-reviewed artikelen. De exacte samenstelling van TheoPhysEval, het aantal geteste problemen en de onafhankelijkheid van de evaluatie zijn niet volledig in het openbaar uiteengezet. Totdat de methodologie is gepubliceerd en gerepliceerd, moet het cijfer van 98% worden behandeld als een bewering om in de gaten te houden, niet als een vaststaand feit.
Toch vangt het verhaal een stemming. Decennialang is de theoretische natuurkunde een van de meest menselijke bezigheden geweest, die intuïtie, wiskundige vaardigheid en jarenlange training vereist. Een model dat naar verluidt een rekenfout van een expert kan opsporen, suggereert dat die muren lager zijn dan velen aannamen. Of dit een doorbraak is of een goed getimede kop, de discussie over AI in de wetenschap is verschoven van of het kan helpen naar hoeveel van het werk het uiteindelijk zal doen.