Studi Harvard dan Google: GPT-6 Astra Memecahkan 98% Masalah Fisika
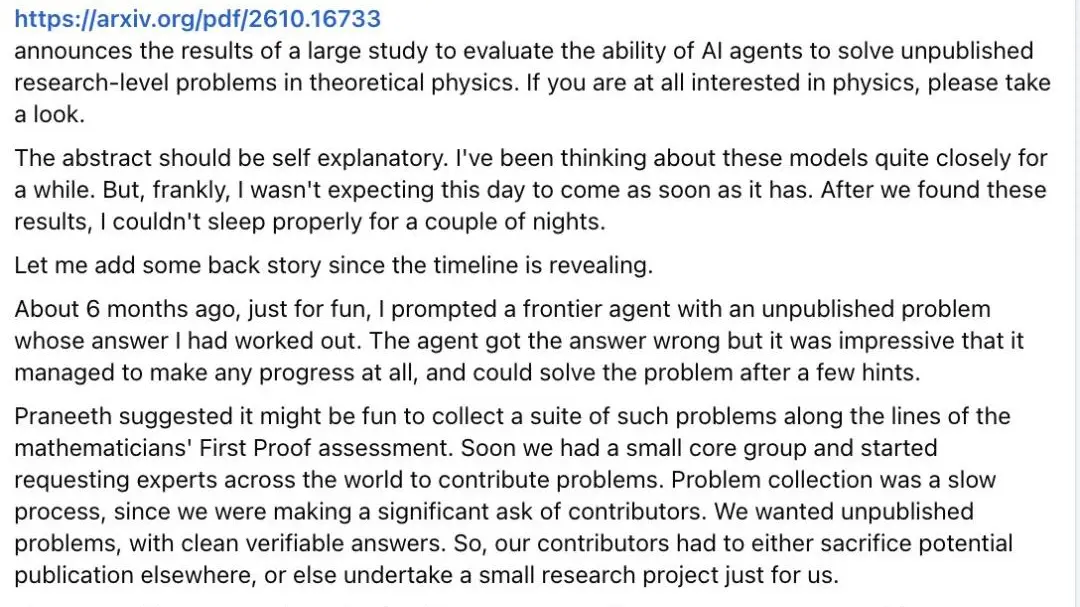
Kolaborasi riset antara Harvard dan Google telah memicu kegemparan di kalangan akademisi dengan sebuah tolok ukur yang menguji AI terdepan pada masalah fisika teoretis yang belum dipublikasikan. Menurut laporan yang beredar di media teknologi Tiongkok, evaluasi yang disebut TheoPhysEval itu meminta model-model canggih untuk menangani masalah-masalah baru yang menurut laporan membutuhkan waktu seharian bagi para ahli manusia terbaik untuk menyelesaikannya. Model yang menonjol adalah GPT-6 Astra, yang dilaporkan menyelesaikan 98% masalah.
Detail yang paling mencolok bukanlah skor hampir sempurna itu, melainkan bagaimana model tersebut mencapainya. Laporan menyebutkan GPT-6 Astra awalnya mendapat skor 88%, lalu menandai kesalahan perhitungan pada salah satu masalah yang disusun oleh para ahli manusia yang merancang tes tersebut. Setelah para ahli meninjau dan mengakui kesalahan itu, skor model naik menjadi 98%. Anekdot itu, jika akurat, menandai momen simbolis: sebuah sistem AI tidak hanya menjawab pertanyaan terdepan tetapi juga mengoreksi orang-orang yang menulisnya.
TheoPhysEval dirancang untuk menghindari masalah kontaminasi yang menghantui banyak tolok ukur AI. Alih-alih menggunakan makalah yang sudah dipublikasikan yang mungkin telah dilihat model selama pelatihan, tes ini menggunakan masalah yang belum dipublikasikan dan baru ditulis. Idenya adalah menguji penalaran sejati alih-alih mengingat. Jika sebuah model dapat menangani fisika teoretis baru tanpa pernah menemui masalah persisnya sebelumnya, itu menunjukkan kemampuan yang lebih umum.
Hasil ini muncul di tengah percepatan yang lebih luas dalam kemampuan matematika dan sains AI. Pada awal Oktober, OpenAI mengklaim bahwa sistem mereka telah membuktikan hipotesis kuasi-Riemann, sebuah hasil yang menurut matematikawan setara Medali Fields jika dihasilkan oleh manusia. Dalam beberapa hari, peneliti melaporkan bahwa dengan bantuan AI, matematikawan telah membuktikan suatu bentuk hipotesis Riemann yang digeneralisasi. Laju ini membuat sebagian akademisi bersemangat dan sebagian lainnya gelisah.
Peneliti MIT juga angkat bicara, dengan laporan yang mengutip tes mereka sendiri yang menunjukkan bahwa AI terdepan telah membuat kemajuan pesat dalam memecahkan masalah sains teoretis selama dua tahun terakhir. Garis tren menunjukkan bahwa AI bergeser dari alat yang membantu ilmuwan menjadi peserta yang dapat mengusulkan dan memeriksa hasil. Pergeseran itu memunculkan pertanyaan tentang bagaimana kredit, verifikasi, dan tinjauan sejawat seharusnya bekerja ketika mesin terlibat dalam prosesnya.
Kaum skeptis memperingatkan bahwa hasil tolok ukur bisa dilebih-lebihkan, terutama ketika detailnya disaring melalui liputan pers alih-alih makalah yang ditinjau sejawat. Komposisi persis TheoPhysEval, jumlah masalah yang diuji, dan independensi evaluasi belum dirinci sepenuhnya di depan publik. Sampai metodologinya dipublikasikan dan direplikasi, angka 98% harus diperlakukan sebagai klaim yang perlu dicermati, bukan fakta yang sudah pasti.
Meski begitu, kisah ini menangkap suatu suasana. Selama beberapa dekade, fisika teoretis termasuk di antara upaya yang paling manusiawi, membutuhkan intuisi, kefasihan matematika, dan pelatihan bertahun-tahun. Sebuah model yang dilaporkan dapat menemukan kesalahan aritmetika seorang ahli menunjukkan bahwa dinding-dinding itu lebih rendah dari yang diasumsikan banyak orang. Apakah ini terobosan atau berita utama yang tepat waktu, percakapan tentang AI dalam sains telah bergeser dari apakah AI dapat membantu menjadi seberapa banyak pekerjaan yang akhirnya akan dilakukannya.