Studie von Harvard und Google: GPT-6 Astra löst 98 % der Physikprobleme
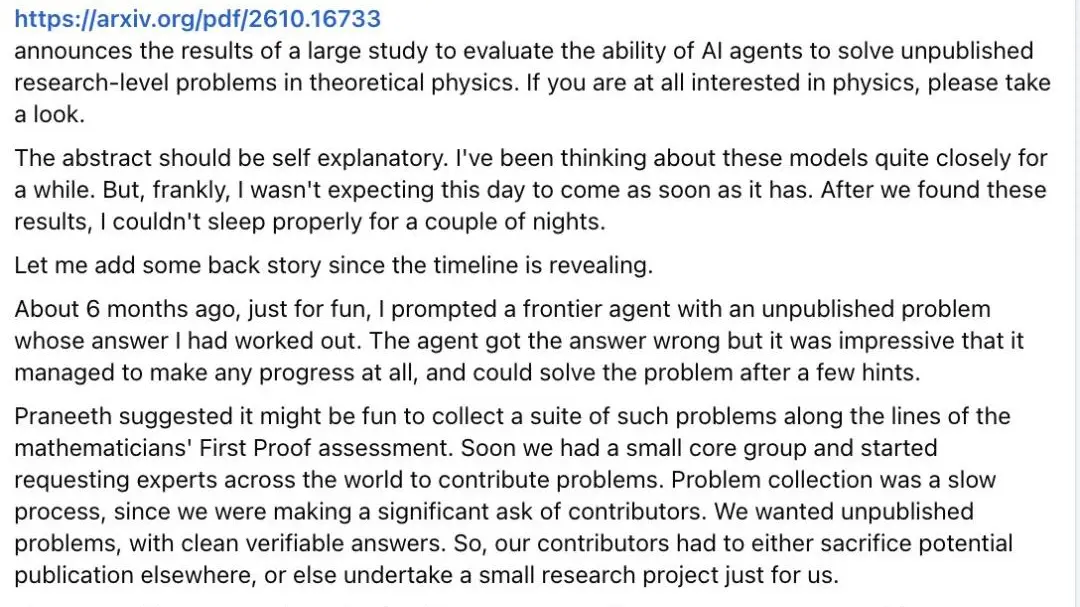
Eine Forschungskooperation zwischen Harvard und Google hat mit einem Benchmark, der Spitzen-KI an unveröffentlichten Problemen der theoretischen Physik testet, in akademischen Kreisen für Aufsehen gesorgt. Berichten zufolge, die in chinesischen Technologiemedien kursieren, wurden bei der als TheoPhysEval bezeichneten Evaluierung fortgeschrittene Modelle gebeten, sich mit neuen Problemen zu befassen, für die nach Angaben führender menschlicher Experten ein ganzer Tag benötigt wird. Der herausragende Akteur war ein Modell namens GPT-6 Astra, das angeblich 98 % der Probleme löste.
Das auffälligste Detail ist nicht die nahezu perfekte Punktzahl, sondern wie das Modell dorthin gelangte. Berichten zufolge erzielte GPT-6 Astra zunächst 88 % und wies dann auf einen Rechenfehler in einem der Probleme hin, die von den menschlichen Experten gestellt worden waren, die den Test entworfen hatten. Nachdem die Experten den Fehler überprüft und anerkannt hatten, stieg die Punktzahl des Modells auf 98 %. Diese Anekdote, wenn sie zutrifft, markiert einen symbolischen Moment: Ein KI-System beantwortet nicht nur eine Frage an der Forschungsfront, sondern korrigiert die Personen, die sie gestellt haben.
TheoPhysEval ist so konzipiert, dass es das Kontaminationsproblem vermeidet, das viele KI-Benchmarks plagt. Statt auf veröffentlichte Arbeiten zurückzugreifen, die die Modelle während des Trainings gesehen haben könnten, werden unveröffentlichte, frisch verfasste Probleme verwendet. Die Idee ist, echtes Schlussfolgern statt Erinnern zu testen. Wenn ein Modell neuartige Probleme der theoretischen Physik durcharbeiten kann, ohne das genaue Problem zuvor angetroffen zu haben, deutet das auf eine allgemeinere Fähigkeit hin.
Das Ergebnis kommt inmitten einer breiteren Beschleunigung der mathematischen und wissenschaftlichen Fähigkeiten von KI. Anfang Oktober behauptete OpenAI, seine Systeme hätten eine Quasi-Riemann-Hypothese bewiesen, ein Ergebnis, das Mathematiker als Fields-Medaille-würdig bezeichneten, wenn es von einem Menschen erbracht worden wäre. Innerhalb weniger Tage berichteten Forscher, dass Mathematiker mit KI-Unterstützung eine Form der verallgemeinerten Riemann-Hypothese bewiesen hätten. Das Tempo hat einige Akademiker begeistert und andere beunruhigt.
Auch Forscher des MIT haben sich geäußert; Berichte zitieren ihre eigenen Tests, die zeigen, dass Spitzen-KI in den letzten zwei Jahren schnelle Fortschritte beim Lösen theoretischer Wissenschaftsprobleme gemacht hat. Die Trendlinien deuten darauf hin, dass sich KI von einem Werkzeug, das Wissenschaftler unterstützt, zu einem Teilnehmer wandelt, der Ergebnisse vorschlagen und überprüfen kann. Dieser Wandel wirft Fragen dazu auf, wie Anerkennung, Verifizierung und Peer-Review funktionieren sollten, wenn eine Maschine im Prozess involviert ist.
Skeptiker warnen, dass Benchmark-Ergebnisse übertrieben werden können, insbesondere wenn Details durch Medienberichterstattung statt durch peer-reviewte Arbeiten gefiltert werden. Die genaue Zusammensetzung von TheoPhysEval, die Anzahl der getesteten Probleme und die Unabhängigkeit der Evaluierung wurden nicht vollständig öffentlich dargelegt. Solange die Methodik nicht veröffentlicht und repliziert ist, sollte die Zahl von 98 % als eine Behauptung betrachtet werden, die man im Auge behalten sollte, nicht als gesicherte Tatsache.
Dennoch fängt die Geschichte eine Stimmung ein. Jahrzehntelang gehörte die theoretische Physik zu den menschlichsten Tätigkeiten, die Intuition, mathematische Gewandtheit und jahrelange Ausbildung erfordert. Ein Modell, das angeblich den Arithmetikfehler eines Experten erkennen kann, deutet darauf hin, dass diese Hürden niedriger sind, als viele annahmen. Ob Durchbruch oder gut getimte Schlagzeile – die Diskussion über KI in der Wissenschaft hat sich von der Frage, ob sie helfen kann, dahin verschoben, wie viel der Arbeit sie letztlich erledigen wird.