哈佛與谷歌研究:GPT-6 Astra 解決 98% 物理問題
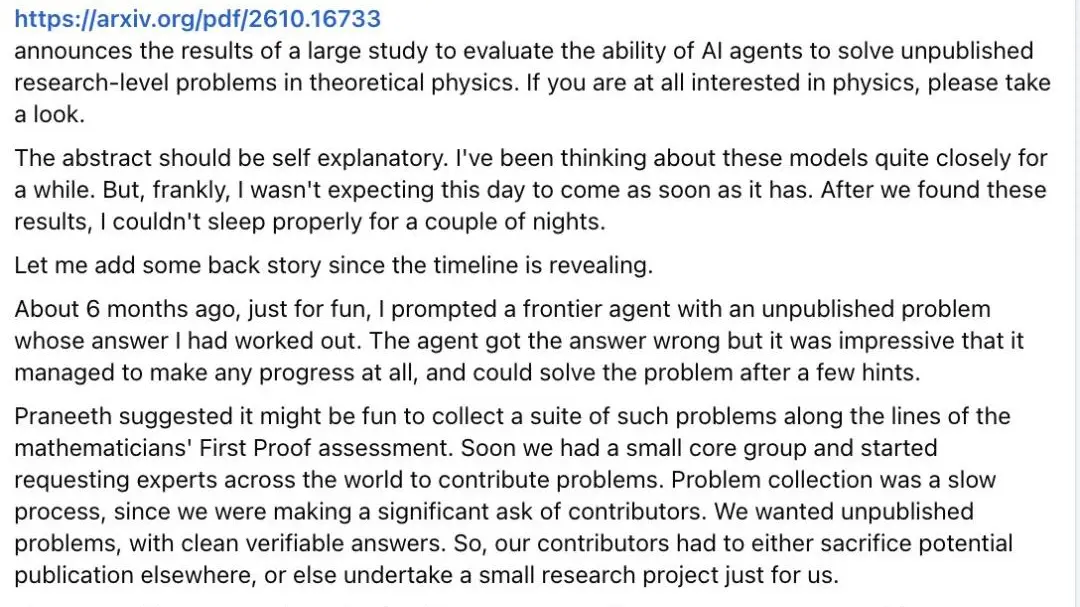
哈佛大學與谷歌的一項研究合作在學術界引起轟動,他們推出了一個基準,用於測試前沿 AI 解決未發表的理論物理問題的能力。據中國科技媒體流傳的報導,這項名為 TheoPhysEval 的評估要求先進模型處理新問題,據稱頂尖人類專家需要一整天才能解決。表現最突出的是名為 GPT-6 Astra 的模型,據報導解決了 98% 的問題。
最引人注目的細節不是近乎完美的分數,而是模型如何達到這一分數。報導稱,GPT-6 Astra 最初得分為 88%,隨後指出設計測試的人類專家所設置的一道題目中有一個計算錯誤。在專家審查並承認錯誤後,該模型的分數升至 98%。這一軼事如果準確,標誌著一個象徵性時刻:一個 AI 系統不僅回答了一個前沿問題,還糾正了出題者。
TheoPhysEval 的設計旨在避免困擾許多 AI 基準的污染問題。它不使用模型在訓練期間可能見過的已發表論文,而是使用未發表的新撰寫問題。其理念是測試真正的推理能力而非記憶。如果一個模型能夠處理新穎的理論物理問題而之前從未遇到過確切的問題,這表明它具有更通用的能力。
這一結果出現之際,AI 的數學和科學能力正在更廣泛地加速。10 月初,OpenAI 聲稱其系統證明了準黎曼假設,數學家稱如果由人類產生,這一結果堪稱菲爾茲獎級別。幾天之內,研究人員報告稱,在 AI 的幫助下,數學家證明了廣義黎曼假設的一種形式。這一速度讓一些學者興奮不已,也讓另一些人感到不安。
麻省理工學院的研究人員也發表了看法,報導引用他們自己的測試表明,前沿 AI 在過去兩年中在解決理論科學問題方面取得了快速進展。趨勢線表明,AI 正在從協助科學家的工具轉變為能夠提出和檢查結果的參與者。這種轉變引發了關於當機器參與其中時,功勞歸屬、驗證和同行評審應如何運作的問題。
懷疑者警告說,基準結果可能被誇大,尤其是當細節通過新聞報導而非同行評審論文傳播時。TheoPhysEval 的確切構成、測試的問題數量以及評估的獨立性尚未在公開場合充分詳細說明。在方法論發表並被複製之前,98% 這個數字應被視為一個值得關注的說法,而非既定事實。
儘管如此,這個故事捕捉到了一種情緒。幾十年來,理論物理一直是最具人類特色的追求之一,需要直覺、數學流暢性和多年的訓練。一個據報導能發現專家算術失誤的模型表明,這些壁壘比許多人想像的要低。無論這是突破還是適時的新聞頭條,關於 AI 在科學中的對話已經從它是否能提供幫助轉變為它最終將承擔多少工作。