Studio di Harvard e Google: GPT-6 Astra risolve il 98% dei problemi di fisica
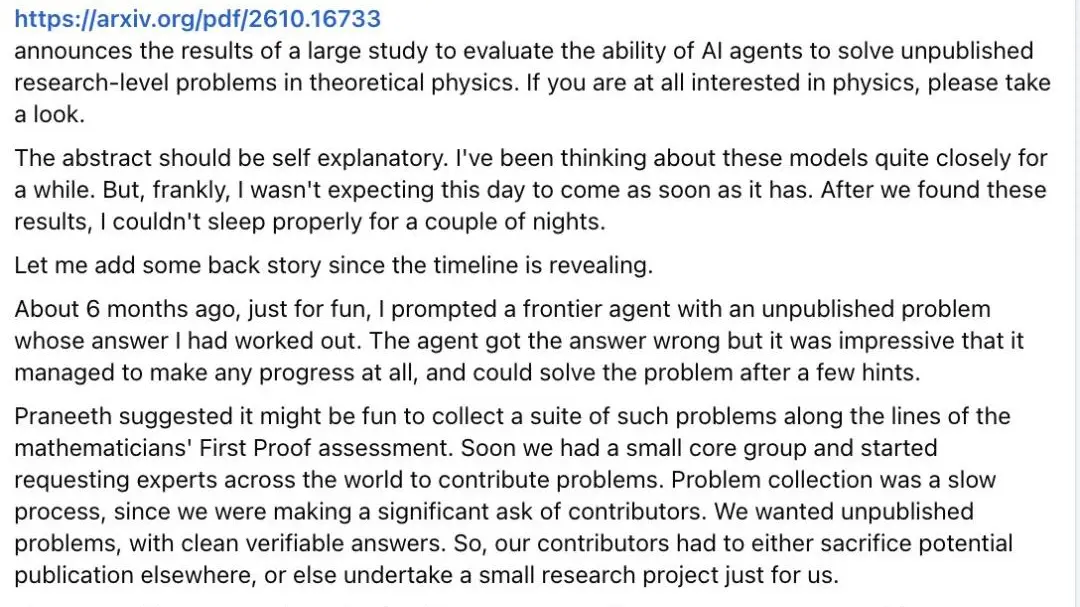
Una collaborazione di ricerca tra Harvard e Google ha suscitato scalpore negli ambienti accademici con un benchmark che mette alla prova l’IA di frontiera su problemi di fisica teorica non pubblicati. Secondo i resoconti che circolano nei media tecnologici cinesi, la valutazione, chiamata TheoPhysEval, ha chiesto a modelli avanzati di affrontare problemi nuovi che, secondo quanto riportato, i migliori esperti umani impiegano un’intera giornata per risolvere. Il modello che si è distinto è stato indicato come GPT-6 Astra, che secondo le fonti avrebbe risolto il 98% dei problemi.
Il dettaglio più sorprendente non è il punteggio quasi perfetto, ma come il modello ci è arrivato. I resoconti affermano che GPT-6 Astra ha inizialmente ottenuto l’88%, per poi segnalare un errore di calcolo in uno dei problemi impostati dagli esperti umani che hanno progettato il test. Dopo che gli esperti hanno esaminato e riconosciuto l’errore, il punteggio del modello è salito al 98%. Questo aneddoto, se accurato, segna un momento simbolico: un sistema di IA non solo risponde a una domanda di frontiera, ma corregge le persone che l’hanno scritta.
TheoPhysEval è progettato per evitare il problema della contaminazione che affligge molti benchmark di IA. Invece di attingere a articoli pubblicati che i modelli potrebbero aver visto durante l’addestramento, utilizza problemi inediti e scritti di recente. L’idea è testare il ragionamento genuino piuttosto che il ricordo. Se un modello riesce a risolvere problemi di fisica teorica nuovi senza averli mai incontrati prima, ciò suggerisce una capacità più generale.
Il risultato arriva in un momento di più ampia accelerazione delle capacità matematiche e scientifiche dell’IA. All’inizio di ottobre, OpenAI ha affermato che i suoi sistemi avevano dimostrato una quasi-ipotesi di Riemann, un risultato che i matematici hanno descritto come degno di una Medaglia Fields se prodotto da un essere umano. Nel giro di pochi giorni, i ricercatori hanno riferito che, con l’assistenza dell’IA, i matematici avevano dimostrato una forma dell’ipotesi di Riemann generalizzata. Il ritmo ha lasciato alcuni accademici entusiasti e altri inquieti.
Anche i ricercatori del MIT sono intervenuti, con resoconti che citano i loro test secondo cui l’IA di frontiera ha fatto rapidi progressi nella risoluzione di problemi scientifici teorici negli ultimi due anni. Le tendenze suggeriscono che l’IA si sta spostando da strumento che assiste gli scienziati a partecipante in grado di proporre e verificare risultati. Questo cambiamento solleva interrogativi su come dovrebbero funzionare il riconoscimento, la verifica e la revisione paritaria quando c’è una macchina nel processo.
Gli scettici avvertono che i risultati dei benchmark possono essere sopravvalutati, soprattutto quando i dettagli vengono filtrati attraverso la copertura mediatica anziché da articoli sottoposti a revisione paritaria. La composizione esatta di TheoPhysEval, il numero di problemi testati e l’indipendenza della valutazione non sono stati completamente dettagliati in pubblico. Finché la metodologia non sarà pubblicata e replicata, la cifra del 98% dovrebbe essere trattata come un’affermazione da tenere d’occhio piuttosto che come un fatto stabilito.
Tuttavia, la storia cattura un’atmosfera. Per decenni, la fisica teorica è stata tra le attività più umane, richiedendo intuizione, fluidità matematica e anni di formazione. Un modello che, secondo quanto riportato, riesce a individuare un errore aritmetico di un esperto suggerisce che quelle barriere sono più basse di quanto molti pensassero. Che si tratti di una svolta o di un titolo ben calibrato, la conversazione sull’IA nella scienza si è spostata dal se può aiutare a quanto del lavoro finirà per svolgere.