Исследование Гарварда и Google: GPT-6 Astra решает 98% задач по физике
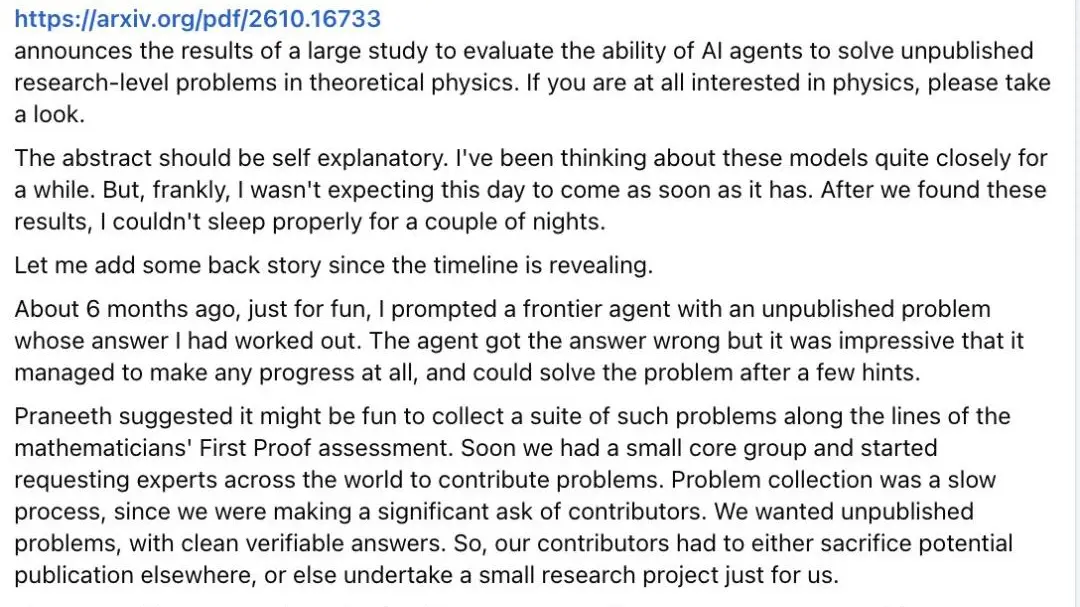
Совместное исследование Гарварда и Google вызвало переполох в академических кругах благодаря бенчмарку, который проверяет передовой ИИ на неопубликованных задачах по теоретической физике. Согласно сообщениям, распространяющимся в китайских технологических СМИ, оценка под названием TheoPhysEval предлагала продвинутым моделям решить свежие задачи, на которые, по имеющимся данным, ведущим экспертам-людям требуется целый день. Лучшим исполнителем стала модель под названием GPT-6 Astra, которая, как сообщается, решила 98% задач.
Самая поразительная деталь — не почти идеальный результат, а то, как модель к нему пришла. Сообщается, что GPT-6 Astra изначально набрала 88%, а затем указала на ошибку в расчётах в одной из задач, составленных экспертами-людьми, разработавшими тест. После того как эксперты проверили и признали ошибку, оценка модели выросла до 98%. Этот эпизод, если он точен, знаменует символический момент: система ИИ не только отвечает на передовой вопрос, но и исправляет тех, кто его составил.
TheoPhysEval разработан так, чтобы избежать проблемы загрязнения данных, которая преследует многие бенчмарки ИИ. Вместо использования опубликованных статей, которые модели могли видеть во время обучения, он применяет неопубликованные, только что написанные задачи. Идея — проверить подлинное рассуждение, а не запоминание. Если модель может разобраться в новой теоретической физике, не сталкиваясь с точной задачей раньше, это говорит о более общих способностях.
Результат появился на фоне более широкого ускорения математических и научных способностей ИИ. В начале октября OpenAI заявила, что её системы доказали квази-гипотезу Римана — результат, который математики назвали достойным Филдсовской премии, если бы его получил человек. В течение нескольких дней исследователи сообщили, что с помощью ИИ математики доказали форму обобщённой гипотезы Римана. Такой темп одних академиков воодушевил, а других встревожил.
Исследователи MIT также высказались: в сообщениях цитируются их собственные тесты, показывающие, что за последние два года передовой ИИ добился быстрого прогресса в решении задач теоретической науки. Тренды указывают на то, что ИИ превращается из инструмента, помогающего учёным, в участника, способного предлагать и проверять результаты. Этот сдвиг ставит вопросы о том, как должны работать признание заслуг, верификация и рецензирование, когда в процессе участвует машина.
Скептики предупреждают, что результаты бенчмарков могут быть преувеличены, особенно когда детали проходят через прессу, а не через рецензируемые статьи. Точный состав TheoPhysEval, количество проверенных задач и независимость оценки не были полностью раскрыты публично. Пока методология не опубликована и не воспроизведена, к цифре 98% следует относиться как к утверждению, за которым стоит следить, а не как к установленному факту.
Тем не менее история отражает настроение. На протяжении десятилетий теоретическая физика была одним из самых человеческих занятий, требующим интуиции, математической беглости и многих лет обучения. Модель, которая, как сообщается, может заметить арифметическую ошибку эксперта, говорит о том, что эти стены ниже, чем многие предполагали. Прорыв это или своевременный заголовок, разговор об ИИ в науке сместился с вопроса, может ли он помочь, к вопросу, какую часть работы он в конечном итоге выполнит.