OpenAI, 자사 AI가 미해결 수학 문제 372개를 풀었다고 주장… 수학자들은 회의적
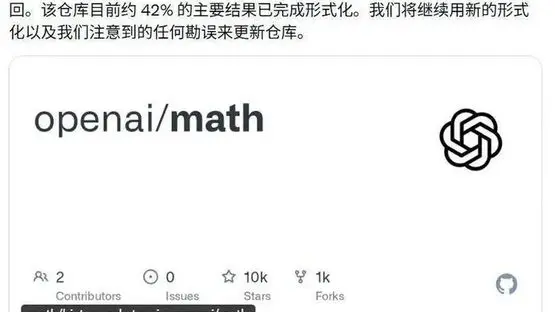
10월 초, OpenAI는 722편의 수학 원고를 GitHub에 공개했다. 모두 회사가 대중에게 공개한 적 없는 단일 내부 모델이 생성한 것이다. OpenAI에 따르면, 이 시스템은 정수론, 기하학, 확률론, 이론 컴퓨터 과학 등 17개 수학 분야에 걸쳐 약 4,000개의 미해결 문제를 공략해 그중 372개에서 결과를 도출했다. 이 발표는 중국 수학자 왕홍이 카케가와 추측의 3차원 버전에 관한 연구로 수학계 최고 영예인 필즈상을 수상한 지 채 3개월도 지나지 않아 나왔다. OpenAI의 모델은 회사가 시사한 대로 한 차원 더 나아갔다는 것이다.
이러한 프레이밍이 이 발표를 널리 퍼뜨렸다. 수학은 인공지능에게 뜻밖의 시험대가 되었다. 에세이 작성이나 이미지 생성과 달리 증명은 검증할 수 있기 때문이다. 올바른 증명은 영원히 올바르며, 잘못된 증명은 유능한 대학원생이라면 누구나 무너뜨릴 수 있다. 자연스러운 심판은 마케팅 부서가 아니라 필즈상 수상자들이다.
문제는 양이다. 722편의 원고는 논문이 아니다. 작은 도서관이며, 이를 읽으려면 그것을 쓴 것과 같은 종류의 모델에 외주할 수 없는 느리고 대립적인 주의가 필요하다. 파일을 읽기 시작한 수학자들은 뒤섞인 풍경을 묘사한다. 특정 단계까지는 그럴듯해 보이는 논증, 중간에 조용히 의미가 바뀌는 정의, 그리고 때때로 진정으로 새로운 것으로 보이는 결과들이다.
중국 과학 저술가들은 더 직설적이었다. 널리 공유된 한 에세이는 이번 공개를, 연구자들이 코를 막고 금을 찾아 체로 거르는 쓰레기 산의 발견에 비유했다. 그 이미지는 불친절하지만, 실제로 필요한 노동을 포착한다. 372개의 주장된 결과 중 어느 것이 인간 전문가의 검증을 견딜지 누군가는 한 줄 한 줄 판단해야 한다.
이는 머신러닝에서 익숙한 패턴이다. 후보 해를 생성하는 시스템은 수학이든, 신약 개발이든, 재료 과학이든, 이를 검증할 수 있는 인간을 훨씬 앞지른다. 검증이 병목이 되고, 그 병목이 도구의 진정한 가치를 결정한다. 1만 개의 가설을 제안하는 모델은 그것을 시험할 수 있는 실험실만큼만 유용하다.
모델이 무엇을 하는지에 대한 더 깊은 질문도 있다. 수학자들은 증명을 찾는 것과 정리가 왜 참인지 이해하는 것을 구분한다. 기계는 결과를 필연적으로 만드는 구조를 파악하지 않고도 유효한 단계의 연쇄를 탐색할 수 있다. 그리고 인간이 결과를 새로운 사례로 확장할 수 있게 하는 것은 바로 그 구조다. OpenAI의 원고가 유효한 증명을 담고 있지만 통찰이 없다면, 그것들은 여전히 유용할 수 있다. 그러나 그것들만으로는 이 분야가 사고하는 방식을 바꾸지 못할 것이다.
현재로서 정직한 답은 아무도 모른다는 것이다. 원고는 공개되어 있고, 주장은 검증할 수 있을 만큼 구체적이며, 검증은 시작되었다. 수학이 항상 논쟁을 해결해 온 방식이며, 이는 제품 발표보다 느린 과정이다.
이번 사건이 보여주는 것은 AI 기업들이 수학을 가장 신뢰할 수 있는 주장을 펼칠 수 있는 무대로 결정했다는 점이다. 이 분야는 AI 논쟁에서 드문 것을 제공한다. 누구의 의견에도 의존하지 않는 판정이다. 372개의 결과 중 일부라도 버텨낸다면, 이번 공개는 이정표로 기억될 것이다. 대부분이 검증 아래 무너진다면, 텍스트 생성과 지식 생산 사이의 간극에 대한 교훈으로 기억될 것이다.