Ling 3.2 Flash van Ant: een groot skelet met een kleine schakelaar
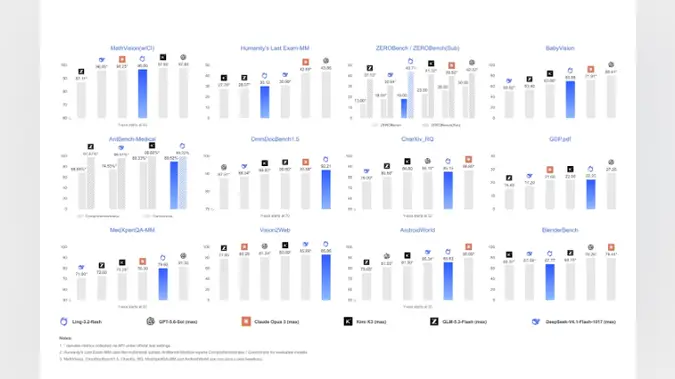
Het BaiLing-onderzoeksteam van Ant Group heeft een nieuw multimodaal model uitgebracht, Ling-3.2-flash, en het kopnummer is een gespleten persoonlijkheid: 560 miljard totale parameters, maar slechts 25 miljard die bij elke afzonderlijke stap worden aangezet. Het ontwerp volgt het draaiboek van mixture-of-experts — een grote poel van aangeleerde kennis waarvan per token een klein deel wordt afgevuurd — waardoor de kennisinhoud van een gigantisch model behouden blijft terwijl de kosten van elke forward pass worden gedrukt.
Het team presenteert dit als een evenwichtsoefening in plaats van een pure grootterace. Een dense model van vergelijkbare totale omvang zou veel duurder zijn om te bedienen; een klein dense model zou goedkoper zijn maar dunner op kennis. Ling-3.2-flash zit daartussenin, en Ant positioneert het tegenover Claude Opus 5, de frontier-assistent van Anthropic, als een goedkoper alternatief voor multimodaal werk.
Vier capaciteiten werden bij de lancering benadrukt. De architectuur is native multimodaal: ze verwerkt afbeeldingen, tekst en video in plaats van een visie-adapter op een taalmodel te schroeven. Ze is afgestemd op complex visueel begrip, dat wil zeggen diep redeneren over afbeeldingen en video. Ze is gebouwd voor lange agenttaken met meerdere stappen, waarbij het model een doel over vele beurten moet vasthouden en moet handelen op wat het ziet én op wat het leest. En ze verwerkt 3D-content, een knipoog naar Ants belangstelling voor ruimtelijke en ontwerpworkflows.
De meest praktische toevoeging is een feedbacklus. Ling-3.2-flash kan het resultaat van zijn eigen acties — een gerenderde afbeelding, een gebruikersinterface, een foutmelding — als nieuwe input nemen en zichzelf corrigeren. Als een tool-aanroep mislukt, kan het de fout lokaliseren en opnieuw proberen in plaats van vast te lopen. Ant beschrijft ook een mechanisme voor herstel van afwijkingen waarmee het model zich kan aanpassen wanneer stappen midden in een taak misgaan, wat van belang is voor agents die onbeheerd draaien.
Een contextvenster van een miljoen tokens schraagt dat. Lange contexten zijn wat een agent in staat stelt een taakgeschiedenis, een codebase of een stapel documenten in het vizier te houden zonder voortdurend samen te vatten, en ze worden dit seizoen een standaardclaim bij Chinese modelreleases.
De architectuur combineert zeven lagen van de ene attention-variant met een enkele laag van een andere, een hybride patroon dat de kosten van het verwerken van lange sequenties moet drukken. Ant heeft geen onafhankelijke benchmarkresultaten gepubliceerd, dus de vergelijkingen met Claude Opus 5 blijven voorlopig de eigen framing van het bedrijf.
De release valt in een drukke periode voor Chinese AI. Kimi Hosted Agents van Moonshot AI, Omni 1.2 Flash van Google en een open-source klein model van Taobao’s MNN-team kwamen allemaal in dezelfde nieuwscyclus, en de Qwen-familie van Alibaba is al ingebed in Siri voor Chinese gebruikers. Voor ontwikkelaars is de praktische vraag minder welk model bovenaan een leaderboard staat dan welk model goedkoop genoeg is om op lange taken te blijven draaien.
Ants pitch ligt precies op die as: multimodaal redeneren dicht bij de frontier tegen activeringskosten die dichter bij een middelgroot model liggen. Of bedrijven het kopen, hangt af van of de zelfcorrectie buiten demo’s standhoudt — en van prijzen die Ant nog niet heeft bekendgemaakt.