Ling 3.2 Flash d'Ant teste un grand squelette avec un petit interrupteur
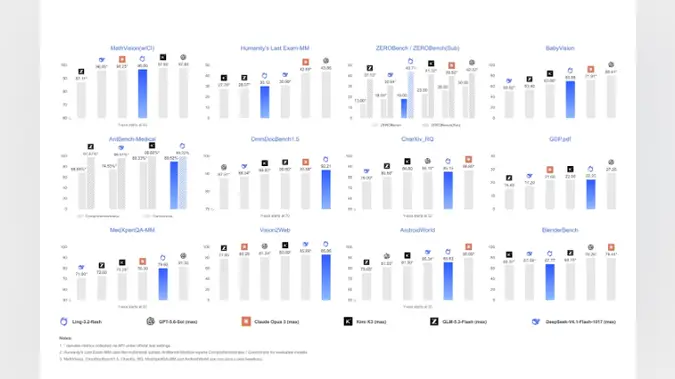
L’équipe de recherche BaiLing d’Ant Group a publié un nouveau modèle multimodal baptisé Ling-3.2-flash, et le chiffre qui fait la une révèle une double personnalité : 560 milliards de paramètres au total, mais seulement 25 milliards activés à chaque étape. Le design suit la recette du mélange d’experts — un vaste réservoir de connaissances apprises, dont une petite fraction est sollicitée par token —, ce qui préserve la capacité de connaissances d’un modèle géant tout en contenant le coût de chaque passe avant.
L’équipe présente cela comme un exercice d’équilibre plutôt qu’une course à la taille brute. Un modèle dense de taille totale comparable coûterait bien plus cher à servir ; un petit modèle dense serait moins cher mais plus pauvre en connaissances. Ling-3.2-flash se situe entre les deux, et Ant le positionne face à Claude Opus 5, l’assistant de pointe d’Anthropic, comme une alternative moins coûteuse pour les tâches multimodales.
Quatre capacités ont été mises en avant au lancement. L’architecture est nativement multimodale : elle traite images, texte et vidéo au lieu d’ajouter un adaptateur de vision à un modèle de langage. Elle est optimisée pour la compréhension visuelle complexe, c’est-à-dire le raisonnement approfondi sur des images et des vidéos. Elle est conçue pour les tâches d’agent longues et à plusieurs étapes, où le modèle doit maintenir un objectif sur de nombreux tours et agir à la fois sur ce qu’il voit et sur ce qu’il lit. Et elle gère le contenu 3D, un clin d’œil à l’intérêt d’Ant pour les flux de travail spatiaux et de conception.
L’ajout le plus concret est une boucle de rétroaction. Ling-3.2-flash peut prendre le résultat de ses propres actions — une image rendue, une interface utilisateur, un message d’erreur — comme nouvelle entrée et se corriger. Si un appel d’outil échoue, il peut localiser la défaillance et réessayer au lieu de rester bloqué. Ant décrit aussi un mécanisme de récupération d’anomalies qui permet au modèle de s’adapter lorsque des étapes tournent mal en cours de tâche, ce qui compte pour les agents fonctionnant sans surveillance.
Une fenêtre de contexte d’un million de tokens sous-tend l’ensemble. Les contextes longs sont ce qui permet à un agent de garder à vue l’historique d’une tâche, une base de code ou une pile de documents sans résumer en permanence, et ils deviennent une revendication standard parmi les sorties de modèles chinois cette saison.
L’architecture associe sept couches d’une variante d’attention à une seule couche d’une autre, un schéma hybride destiné à réduire le coût du traitement de longues séquences. Ant n’a pas publié de résultats de référence indépendants, si bien que les comparaisons avec Claude Opus 5 relèvent pour l’instant du cadrage de l’entreprise elle-même.
Le lancement intervient dans une période très chargée pour l’IA chinoise. Les Kimi Hosted Agents de Moonshot AI, Omni 1.2 Flash de Google et un petit modèle open source de l’équipe MNN de Taobao sont tous arrivés dans le même cycle d’actualité, et la famille Qwen d’Alibaba est déjà intégrée à Siri pour les utilisateurs chinois. Pour les développeurs, la question pratique n’est pas tant de savoir quel modèle domine un classement que lequel est assez bon marché pour rester en fonctionnement sur de longues tâches.
L’argument d’Ant porte précisément sur cet axe : un raisonnement multimodal proche de l’état de l’art, à des coûts d’activation plus proches d’un modèle de taille moyenne. L’adoption par les entreprises dépendra de la solidité réelle de l’auto-correction hors des démonstrations — et d’un prix qu’Ant n’a pas encore dévoilé.