Ants Ling 3.2 Flash testet ein großes Skelett mit kleinem Schalter
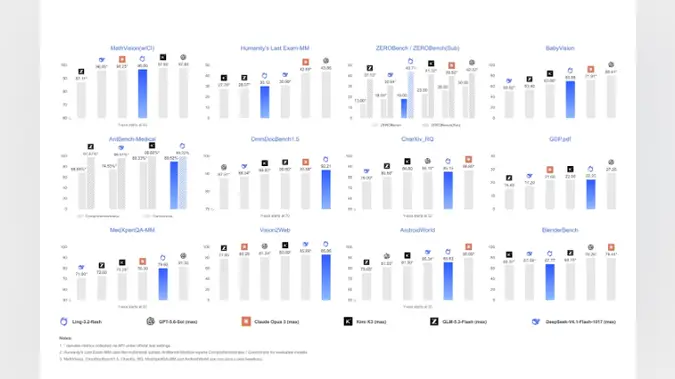
Das Forschungsteam BaiLing von Ant Group hat ein neues multimodales Modell namens Ling-3.2-flash veröffentlicht, und die Schlagzeile verrät eine gespaltene Persönlichkeit: 560 Milliarden Gesamtparameter, aber nur 25 Milliarden, die bei einem einzelnen Schritt aktiviert werden. Das Design folgt dem Mixture-of-Experts-Muster – ein großer Fundus erlernten Wissens, von dem pro Token nur ein kleiner Teil gezündet wird –, was die Wissenskapazität eines riesigen Modells bewahrt und zugleich die Kosten jedes Vorwärtsdurchlaufs niedrig hält.
Das Team stellt dies als Balanceakt dar, nicht als Wettlauf um die reine Größe. Ein dichtes Modell vergleichbarer Gesamtgröße wäre deutlich teurer im Betrieb; ein kleines dichtes Modell wäre billiger, aber wissensärmer. Ling-3.2-flash liegt dazwischen, und Ant positioniert es gegen Claude Opus 5, den Spitzenassistenten von Anthropic, als günstigere Alternative für multimodale Aufgaben.
Vier Fähigkeiten wurden beim Start hervorgehoben. Die Architektur ist nativ multimodal: Sie verarbeitet Bilder, Text und Video, statt einen Vision-Adapter an ein Sprachmodell anzuschrauben. Sie ist auf komplexes visuelles Verständnis abgestimmt, also auf tiefes Schlussfolgern über Bilder und Videos. Sie ist für lange, mehrstufige Agentenaufgaben gebaut, bei denen das Modell ein Ziel über viele Runden hinweg halten und sowohl auf das Gesehene als auch auf das Gelesene reagieren muss. Und sie verarbeitet 3D-Inhalte, eine Anspielung auf Ants Interesse an räumlichen und Design-Workflows.
Die praktischste Neuerung ist eine Rückkopplungsschleife. Ling-3.2-flash kann das Ergebnis seiner eigenen Aktionen – ein gerendertes Bild, eine Benutzeroberfläche, eine Fehlermeldung – als neue Eingabe nehmen und sich selbst korrigieren. Schlägt ein Tool-Aufruf fehl, kann es den Fehler lokalisieren und es erneut versuchen, statt zu blockieren. Ant beschreibt außerdem einen Mechanismus zur Anomaliebehebung, der es dem Modell ermöglicht, sich anzupassen, wenn mitten in der Aufgabe Schritte schiefgehen – wichtig für Agenten, die unbeaufsichtigt laufen.
Ein Kontextfenster von einer Million Tokens bildet die Grundlage dafür. Lange Kontexte sind es, die einem Agenten erlauben, einen Aufgabenverlauf, eine Codebasis oder einen Stapel Dokumente im Blick zu behalten, ohne ständig zusammenzufassen, und sie werden in dieser Saison bei chinesischen Modellveröffentlichungen zur Standardangabe.
Die Architektur kombiniert sieben Schichten einer Attention-Variante mit einer einzigen Schicht einer anderen, ein hybrides Muster, das die Kosten der Verarbeitung langer Sequenzen senken soll. Ant hat keine unabhängigen Benchmark-Ergebnisse veröffentlicht, daher bleiben die Vergleiche mit Claude Opus 5 vorerst die eigene Darstellung des Unternehmens.
Die Veröffentlichung fällt in eine dicht gedrängte Phase der chinesischen KI. Moonshot AIs Kimi Hosted Agents, Googles Omni 1.2 Flash und ein Open-Source-Kleinmodell des MNN-Teams von Taobao erschienen im selben Nachrichtenzyklus, und Alibabas Qwen-Familie ist für chinesische Nutzer bereits in Siri integriert. Für Entwickler ist die praktische Frage weniger, welches Modell eine Bestenliste anführt, als welches billig genug ist, um bei langen Aufgaben einfach weiterzulaufen.
Ants Argument zielt genau auf diese Achse: multimodales Schlussfolgern nahe der Spitze zu Aktivierungskosten, die eher einem mittelgroßen Modell entsprechen. Ob Unternehmen zugreifen, hängt davon ab, ob die Selbstkorrektur außerhalb von Demos wirklich standhält – und vom Preis, den Ant noch nicht genannt hat.