AI एजेंट चुपचाप विफल हो रहे हैं, और AWS इसे पकड़ना चाहता है
जैसे ही कंपनियाँ स्वायत्त AI एजेंटों को काम पर लगाने के लिए दौड़ लगा रही हैं, एक सूक्ष्म खतरा उभर रहा है: चुपचाप विफल होने वाले एजेंट। क्रैश होने या धीमा होने के बजाय, संघर्ष कर रहा एजेंट उसी गति से जवाब देता रहता है जबकि उसके जवाबों की गुणवत्ता चुपचाप घटती जाती है। Amazon Web Services का कहना है कि उसने ग्राहकों के ध्यान देने से पहले इसे पकड़ने का तरीका बनाया है।
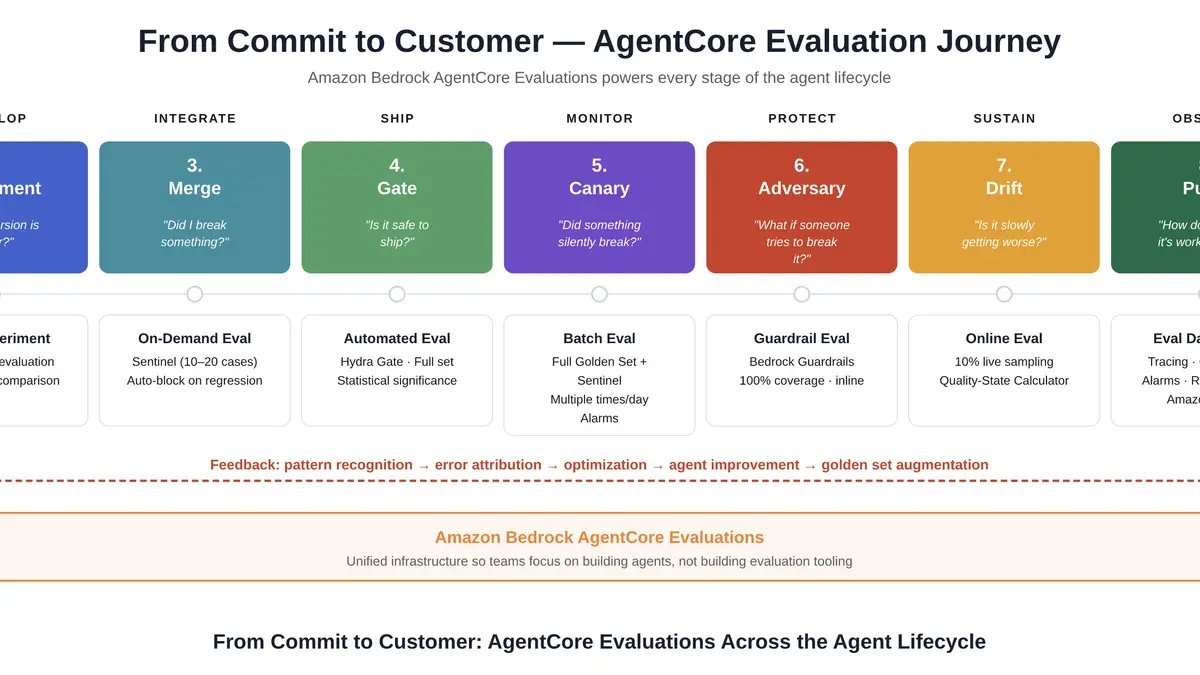
कंपनी ने Amazon Bedrock AgentCore पर आधारित नौ-चरणीय मूल्यांकन ढांचा पेश किया है, जो AI एजेंटों को तैनात करने और प्रबंधित करने का उसका प्लेटफॉर्म है। यह ढांचा एजेंटों को उत्पादन जैसी स्थितियों में परखने के लिए डिज़ाइन किया गया है, जो न केवल यह जाँचता है कि वे जवाब देते हैं या नहीं, बल्कि यह भी कि काम लंबा और जटिल होने पर उनके जवाब सटीक रहते हैं या नहीं। AWS ने इस दृष्टिकोण का विवरण इस सप्ताह प्रकाशित किया।
एजेंट सामान्य चैटबॉट से इसलिए अलग हैं क्योंकि वे सिर्फ बात नहीं करते, बल्कि काम करते हैं। वे वेब ब्राउज़ कर सकते हैं, अन्य सॉफ्टवेयर टूल कॉल कर सकते हैं, कोड चला सकते हैं और सीमित मानवीय निगरानी में बहु-चरणीय कार्य पूरे कर सकते हैं। यही स्वायत्तता चुपचाप विफलता को खतरनाक बनाती है: गलत मीटिंग बुक करने वाला, किसी दस्तावेज़ को गलत पढ़ने वाला या त्रुटिपूर्ण निर्णय लेने वाला एजेंट आत्मविश्वास से काम करता रह सकता है, और बड़े पैमाने पर, बिना किसी के ध्यान दिए।
यह ढांचा एजेंट को नौ अलग-अलग चरणों से गुज़ारता है, बुनियादी सेटअप से लेकर वास्तविक कार्यभार तक और फिर निरंतर निगरानी तक। हर चरण में, मूल्यांकनकर्ता एजेंट के आउटपुट की तुलना अपेक्षित परिणामों से करते हैं, खराब होते जवाबों पर नज़र रखते हैं और यह परखते हैं कि जब कोई टूल कॉल विफल होता है या कोई अनुरोध अस्पष्ट होता है तो एजेंट कैसा व्यवहार करता है। लक्ष्य अस्पष्ट भरोसे को मापने योग्य संकेतों में बदलना है जिन पर टीमें कार्रवाई कर सकें।
भरोसा क्लाउड दिग्गज की AI पेशकशों में एक केंद्रीय विषय बन रहा है। AWS ने Trust in Depth नामक एक स्तरित दृष्टिकोण भी बताया है, जो पाँच विचारों पर आधारित है: दायरा, जानना, सीमित करना, निगरानी करना और साबित करना। उद्देश्य एजेंटों को नियंत्रण खोए बिना अधिक काम लेने देना है, उनकी पहुँच सीमित करके, उन्हें जो पता है उसे परिभाषित करके, उनके कार्यों को सीमित करके, संचालन के दौरान उन पर नज़र रखकर और बाद में उन्होंने क्या किया यह साबित करके।
Amazon Bedrock AgentCore के साथ उत्पादन-तैयार मूल्यांकन ढांचा इस बड़ी पहल में फिट बैठता है। AWS का तर्क है कि कंपनियों को एजेंट परीक्षण को लॉन्च से पहले एकबारगी जाँच के बजाय एक निरंतर अनुशासन मानना चाहिए। जैसे-जैसे एजेंट लंबे, बहु-चरणीय काम संभालते हैं, तेज़ जवाब और सही जवाब के बीच का अंतर उपयोगी ऑटोमेशन और महँगी गलतियों के बीच का अंतर बन जाता है।
व्यापक उद्योग ध्यान दे रहा है। उद्यम चाहते हैं कि एजेंट अधिक काम करें, लेकिन सर्वेक्षण और अधिकारी बार-बार कहते हैं कि उन्हें पूरा भरोसा नहीं है कि वे हर बार सही काम करेंगे। ऐसे टूल जो एजेंट की गुणवत्ता को मान लेने के बजाय दिखाई देने योग्य बनाते हैं, पारंपरिक सॉफ्टवेयर के लिए प्रदर्शन निगरानी की तरह मानक बन सकते हैं।
फिलहाल, AWS का संदेश सरल है: जो एजेंट कभी गलती नहीं करता, वह फिर भी खराब हो सकता है। कंपनी दांव लगा रही है कि कठोर, चरणबद्ध मूल्यांकन ही सतर्क व्यवसायों को वास्तविक काम ऐसे सॉफ्टवेयर को सौंपने के लिए मनाएगा जो स्वयं सोचता और काम करता है।