AI 代理無聲失敗,AWS 欲捕捉此問題
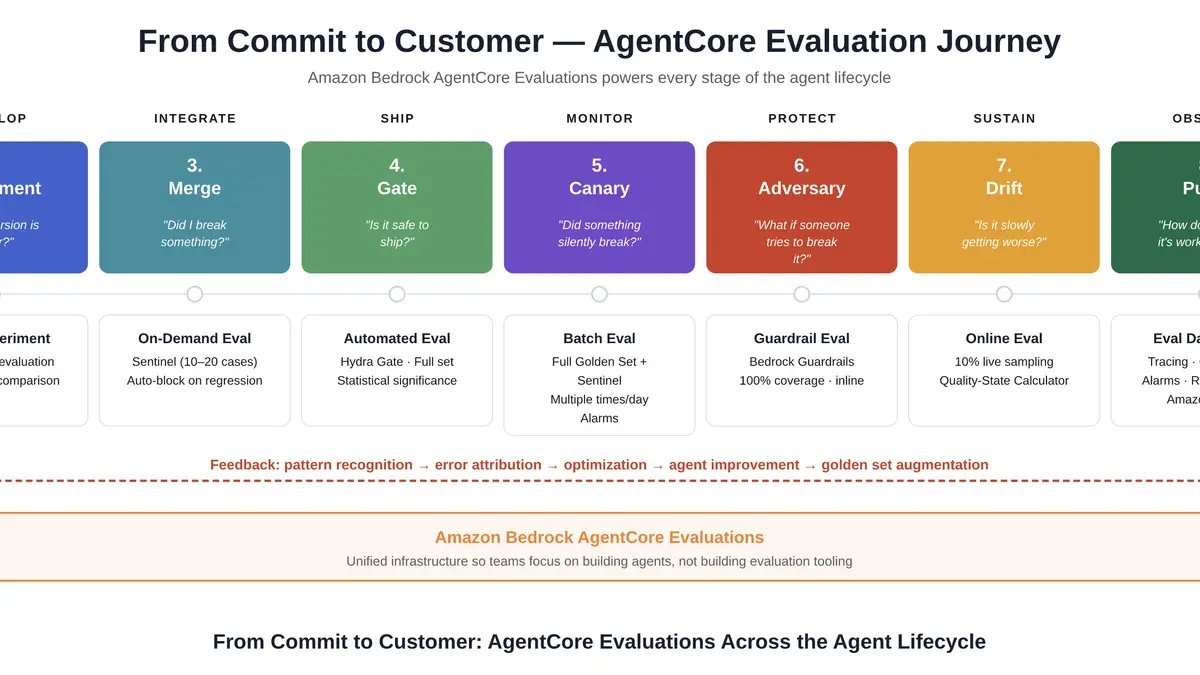
隨著企業競相將自主 AI 代理投入工作,一個微妙的危險正在浮現:代理無聲失敗。陷入困境的代理不會崩潰或減速,而是以相同的速度持續回覆,同時其答案的品質卻悄然侵蝕。Amazon Web Services 表示,它已建立一種方法,能在客戶注意到之前捕捉到這種情況。
該公司推出了一個基於 Amazon Bedrock AgentCore(其用於部署和管理 AI 代理的平台)的九階段評估框架。該框架旨在模擬生產環境的條件下測試代理,不僅檢查它們是否回應,還檢查隨著任務變得更長、更複雜,它們的回應是否保持準確。AWS 本週公佈了該方法的細節。
代理與普通聊天機器人的不同之處在於它們會行動,而不只是說話。它們可以瀏覽網頁、呼叫其他軟體工具、執行程式碼,並在有限的人工監督下完成多步驟任務。這種自主性正是無聲失敗危險的原因:一個代理預訂了錯誤的會議、誤讀文件或做出有缺陷的決定,可能會自信地繼續工作,而且在大規模情況下,無人察覺。
該框架讓代理經歷九個不同階段,從基本設定到現實工作負載,再到持續監控。在每個階段,評估人員將代理的輸出與預期結果進行比較,觀察答案是否退化,並測試當工具呼叫失敗或請求不明確時代理的行為。目標是將模糊的信任轉化為團隊可以採取行動的可測量信號。
信任正成為這家雲端巨頭 AI 產品的一個核心主題。AWS 還描述了一種名為「Trust in Depth」的分層方法,圍繞五個理念構建:範圍、了解、限制、觀察和證明。目的是讓代理承擔更多工作而不失去控制,方法是限制它們可以存取什麼、定義它們知道什麼、約束它們的行動、在運作中觀察它們,並在事後證明它們做了什麼。
一個與 Amazon Bedrock AgentCore 配套的生產就緒評估框架符合這一更大的推動方向。AWS 認為,企業應將代理測試視為一種持續的紀律,而不是發布前的一次性檢查。隨著代理承擔更長、多步驟的工作,快速答案與正確答案之間的差距就成為有用自動化與代價高昂錯誤之間的區別。
更廣泛的行業正在關注。企業希望代理處理更多工作,但調查和高管們一再表示,他們並不完全信任代理每次都能正確行動。讓代理品質變得可見而非假設的工具,可能會像效能監控對傳統軟體那樣成為標準。
目前,AWS 傳達的訊息很簡單:一個從不出錯的代理可能仍在變差。該公司押注,嚴格的階段性評估將說服謹慎的企業將真實任務交給能夠獨立思考和行動的軟體。